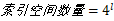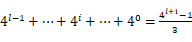
<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://huajunge.github.io/academicpages/feed.xml" rel="self" type="application/atom+xml" /><link href="https://huajunge.github.io/academicpages/" rel="alternate" type="text/html" /><updated>2026-06-17T18:43:57+08:00</updated><id>https://huajunge.github.io/academicpages/feed.xml</id><title type="html">About Me</title><subtitle>personal description</subtitle><author><name>Huajun He</name></author><entry><title type="html">基于键值对数据库的高效轨迹相似查询方案 [ICDE-2022论文]</title><link href="https://huajunge.github.io/academicpages/posts/2022/04/ICDETraSS/" rel="alternate" type="text/html" title="基于键值对数据库的高效轨迹相似查询方案 [ICDE-2022论文]" /><published>2022-04-23T00:00:00+08:00</published><updated>2022-04-23T00:00:00+08:00</updated><id>https://huajunge.github.io/academicpages/posts/2022/04/ICDETraSS</id><content type="html" xml:base="https://huajunge.github.io/academicpages/posts/2022/04/ICDETraSS/"><![CDATA[<p>相似性搜索已成为许多轨迹数据分析任务的重要组成部分。随着物联网技术的快速发展，使得企业收集轨迹数据的途径变多、速度变快，导致许多轨迹分析任务必须从海量轨迹中寻找相似的轨迹。由于轨迹数据结构复杂，具有不规则的空间形状和连续的时间序列属性，存储和查询海量轨迹数据具有挑战性。西南交通大学博士生、京东实习生何华均为第一作者，郑宇教授和李天瑞教授为通讯作者，重庆大学李瑞远副教授、京东智能城市研究院-时空实验室鲍捷和何天赋，以及西安电子科技大学阮思捷博士共同完成的论文《TraSS: Efficient Trajectory Similarity Search Based on Key-Value Data Stores》提出了一种在key-value数据库中快速查询相似轨迹的高效方案。通常，海量轨迹数据可以通过key-value数据库进行管理。然而，现有的key-value数据库只能使用粗粒度的空间索引来存储轨迹数据，并且没有提供高效的查询处理算法来搜索相似的轨迹。TraSS提出了一种新颖的空间索引 XZ<em>，它利用具有不同大小和不规则形状的索引空间来精细地表示轨迹的空间位置和形状。此外，TraSS设计了一个从 XZ</em> 的多维索引空间到一维连续整数域的编码函数，可方便设计高效的轨迹存储策略和快速的轨迹查询处理算法。进一步地，为了提高相似性搜索的效率，TraSS采用两个步骤来修剪不相似的轨迹：（1）全局修剪。它利用 XZ* 索引来修剪没有相似于查询轨迹的索引空间。TraSS的全局剪枝只会挑选出与查询轨迹具有相似大小和形状的索引空间。与之前最先进的索引相比，TraSS的全局剪枝在查询处理过程中减少了高达 66.4% 的 I/O 开销；(2)局部过滤。它以降低相似度计算复杂度的方式来快速过滤不相似的轨迹。TraSS使用 Douglas-Peucker 算法从轨迹中提取代表性特征来加速局部过滤，极大地降低了查询处理过程中产生的计算量。大量实验和实际案例表明TraSS极大地提高了海量轨迹相似查询效率。</p>

<p><span id="wc" style="font-size: 1rem;text-align: center;">[本文总阅读量: <span id="busuanzi_value_page_pv"></span>次]</span></p>

<center>基于键值对数据库的高效轨迹相似查询方案 [ICDE-2022论文]</center>

<center>何华均</center>

<p><img src="https://huajunge.github.io/academicpages/images/posts/TraSS/640.jpeg" alt="img" /></p>

<p>相似性搜索已成为许多轨迹数据分析任务的重要组成部分。随着物联网技术的快速发展，使得企业收集轨迹数据的途径变多、速度变快，导致许多轨迹分析任务必须从海量轨迹中寻找相似的轨迹。由于轨迹数据结构复杂，具有不规则的空间形状和连续的时间序列属性，存储和查询海量轨迹数据具有挑战性。西南交通大学博士生、京东实习生何华均为第一作者，郑宇教授和李天瑞教授为通讯作者，重庆大学李瑞远副教授、京东智能城市研究院-时空实验室鲍捷和何天赋，以及西安电子科技大学阮思捷博士共同完成的论文《TraSS: Efficient Trajectory Similarity Search Based on Key-Value Data Stores》提出了一种在key-value数据库中快速查询相似轨迹的高效方案。通常，海量轨迹数据可以通过key-value数据库进行管理。然而，现有的key-value数据库只能使用粗粒度的空间索引来存储轨迹数据，并且没有提供高效的查询处理算法来搜索相似的轨迹。TraSS提出了一种新颖的空间索引 XZ<em>，它利用具有不同大小和不规则形状的索引空间来精细地表示轨迹的空间位置和形状。此外，TraSS设计了一个从 XZ</em> 的多维索引空间到一维连续整数域的编码函数，可方便设计高效的轨迹存储策略和快速的轨迹查询处理算法。进一步地，为了提高相似性搜索的效率，TraSS采用两个步骤来修剪不相似的轨迹：（1）全局修剪。它利用 XZ* 索引来修剪没有相似于查询轨迹的索引空间。TraSS的全局剪枝只会挑选出与查询轨迹具有相似大小和形状的索引空间。与之前最先进的索引相比，TraSS的全局剪枝在查询处理过程中减少了高达 66.4% 的 I/O 开销；(2)局部过滤。它以降低相似度计算复杂度的方式来快速过滤不相似的轨迹。TraSS使用 Douglas-Peucker 算法从轨迹中提取代表性特征来加速局部过滤，极大地降低了查询处理过程中产生的计算量。大量实验和实际案例表明TraSS极大地提高了海量轨迹相似查询效率。</p>

<p><strong>1 背景</strong></p>

<p>近年来，高速发展的物联网技术使我们能够轻松捕捉移动物体的轨迹。例如，京东6万多位快递员每天可产生超过1T的轨迹日志。如此庞大的轨迹数据需要高效且可扩展的数据管理方案。轨迹数据管理需要支持很多基础的查询操作。例如空间范围查询，它查找经过给定空间范围的轨迹；相似度查询，它查找与给定轨迹相似的所有轨迹。在这些查询中，轨迹相似性搜索是一种十分重要，但计算复杂的基本操作。例如，我们可通过寻找与传染病患者轨迹相似的轨迹来排查患者的密切接触者。轨迹相似性搜索也有利于拼车、轨迹聚类等轨迹分析应用。HBase等key-value数据库实现了大数据的快速写入/读取吞吐量，并可根据行键进行快速查找。因此，它们广泛用于管理大规模数据。现有一些工作利用key-value数据库管理轨迹大数据。然而，它们不能有效地提供轨迹相似性搜索，因为（1）它们以粗略的<strong>表示</strong>来存储轨迹；并且（2）它们缺乏有效的<strong>查询处理</strong>来搜索相似的轨迹。</p>

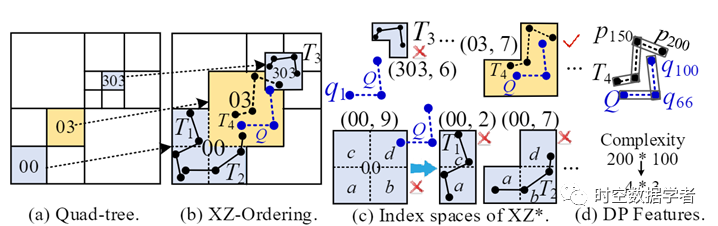
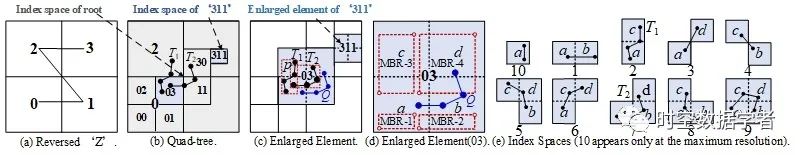
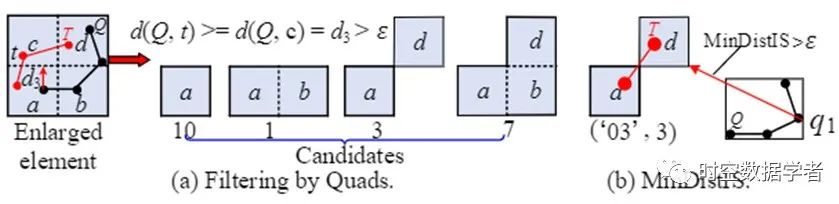
<p><strong>1.1 表示</strong>：轨迹由一系列的多维时空点组成，但key-value数据库使用一维键值对存储对象。因此，我们必须为轨迹对象分配适当的一维键。现有工作使用空间索引，例如 R-trees来表示key-value数据库中的轨迹。它们将轨迹分配到许多索引空间中。每个索引空间都有一个空间边界，并配备了唯一的索引值。因此，我们可以使用该唯一值作为键的一部分来存储和查询轨迹。R-tree 及其变体等动态索引在插入大量数据时不可避免地会调整索引结构。因此，使用动态索引的现有工作在大规模轨迹数据管理中存在可维护性和可扩展性差的问题。由JUST、TrajMesa等工作证明，XZ-Ordering 是在key-value数据库中表示轨迹的更好选择。正如图1(a)(b) 中的箭头所示，XZ-Ordering可以被视为四叉树的扩展, 它将四叉树每个子空间的宽度和高度加倍，形成一个由四个子空间组成的索引空间。XZ-Ordering 利用最小的索引空间来表示轨迹的 MBR（最小边界框）。如图1 (b) 所示，T_1 由较大的索引空间（’00’）表示，而 T_3 由较小的索引空间（’303’）表示。然而，轨迹可能只出现在索引空间的一小部分，例如，T_1 占用其索引空间（“00”）的面积未超过一半。因此，XZ-Ordering 的索引空间对于许多轨迹来说仍然太粗略。导致，在查询时，查询处理很难仅通过修剪 XZ-Ordering 的索引空间来过滤掉不相似轨迹。</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/TraSS/640-16602942945071.png" alt="img" /></p>

<p>图1 轨迹的表示</p>

<p><strong>1.2 查询处理</strong>：因为相似度度量往往相当复杂，所以计算两条轨迹的相似度非常耗时。因此，查询处理阶段有必要提前剔除尽可能多的不相似轨迹，以避免产生不必要的 I/O 开销和计算。扫描存储区域中的所有轨迹并计算它们与查询轨迹的相似度的过程虽实现简单但十分耗时。因此，查询处理阶段经常采用两个步骤来提高查询效率：（1）全局剪枝：避免访问不相关的存储区域。两条相似的轨迹极大可能在空间上彼此接近。因此，我们可以修剪在空间上远离查询轨迹的索引空间。通常，大多数现有空间索引的索引空间是一个能完全包含轨迹 MBR 的矩形。许多现有工作不会修剪与查询轨迹的 MBR 相交的索引空间，从而导致大量错误命中，进而产生不必要的 I/O 开销。如图1(b) 所示，T_1、T_2 和 T_3 是假命中，因为它们距离 查询轨迹Q 较远；(2) 局部过滤：以低复杂度的方式快速去除每个数据区域中的不同轨迹。现有工作使用 MBR 或轨迹的代表点（例如，起点和终点）来过滤不同的轨迹。然而，这些特征并不能精确地表示轨迹的空间形状，使得过滤效率不明显。因此，需要更精准的轨迹特征来快速过滤不相似的轨迹。</p>

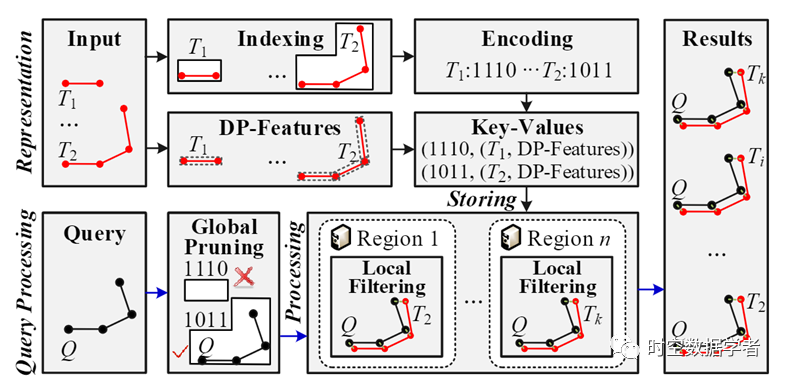
<p><strong>1.3 我们的解决方案：</strong>为了解决上述缺点，我们提出了TraSS，一个高效的大规模轨迹相似查询系统。图 2 概述了TraSS的框架。它的核心操作是轨迹表示和查询处理。</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/TraSS/640-16602942945072.png" alt="img" /></p>

<p>图2 TraSS示意图</p>

<p><strong>（a）轨迹表示：</strong>我们提出了 XZ* 索引(图3)，它提供了一个具有不规则形状的索引空间来表示轨迹。然后，我们用唯一的整数对每个索引空间进行编号，以便于存储和查询轨迹。此外，我们计算轨迹的代表性特征以加速查询处理。如图2所示，轨迹 T_1 和 T_2 由合适的索引空间索引，并配备 DP 特征（图4），最后转换为精准的编码（1110 和 1011）存储至Key-value数据库中。具体而言，我们提出的XZ* 索引能在同一索引空间内表示尽可能多的相似轨迹。它将XZ-Ordering的每个放大元素划分为四个相等的子区域，并利用子区域的组合作为索引空间。较大的索引空间用于覆盖较大的轨迹，而较小的索引空间用于覆盖较小的轨迹。此外，大小类似的轨迹可以通过它们的空间形状来区分。如图1(c)所示，我们将 XZ-Ordering 的放大元素 (00) 分成四等份 ，即a, b, c, d，然后使用组合它们代表不同形状的轨迹，例如，(00, 2) 和 (00, 7) 分别代表 T_1 和 T_2。此外，我们设计了一个双射函数，将索引空间转换为连续整数值，而不是在内存中维护索引结构。它比字符串编码消耗更少的存储开销，并提高了可维护性和可扩展性。</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/TraSS/640-16602942945073.png" alt="img" /></p>

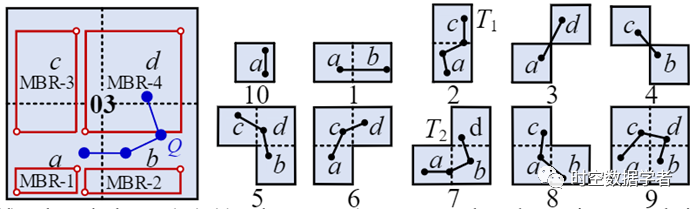
<p>图3 XZ* index</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/TraSS/640-16602942945084.png" alt="img" /></p>

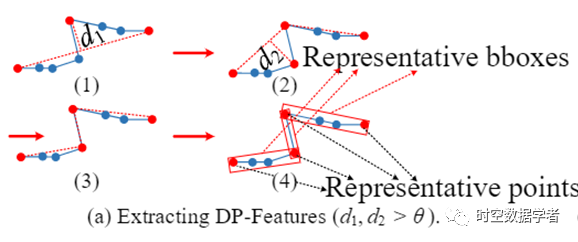
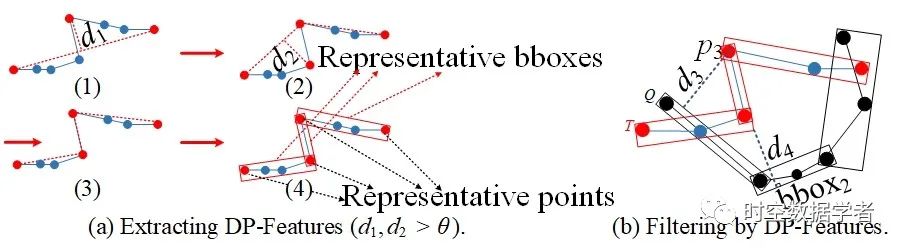
<p>图4 DP-Features</p>

<p><strong>(b) 查询处理：</strong>我们提供高效的查询处理以从数据库中快速查找相似的轨迹。如图2，给定一个查询轨迹Q，我们首先使用全局剪枝过滤掉不可能包含与查询轨迹相似轨迹的索引空间。然后，我们在每个存储区域上利用局部过滤消除剩余索引空间中不会成为最终结果的轨迹。我们的索引可以精确地描述一个轨迹的空间位置和形状。因此，我们只需要访问与查询轨迹Q相似的索引空间即可，进而避免访问与Q不相似的索引空间中的轨迹。直观地，比查询轨迹<em>Q</em>太大或太小的索引空间, 或者和 Q 大小相似但距离 Q 很远的索引空间可以直接被剪枝。如图1(c) 所示，’00’ 的 part- <em>a</em> 距离 Q 很远，因此可以剔除所有由 part-a 组成的索引空间。此外，在 图1(c) 中，Q 的 q1 远离 (303, 6) 的索引空间，这意味着 Q 不与所有位于(303, 6)中的轨迹相似。理论上，与最先进的解决方案相比，我们可以减少多达 83.6%的 I/O 开销。如图1(c) 所示，只有索引空间 (03, 7) 才能覆盖与 Q 相似的轨迹。此外，我们使用 DP (Douglas-Peucker) 算法从轨迹中提取代表点。该算法利用很少的点来近似轨迹的空间形状。此外，我们使用边界框来表示任意两个连续代表点之间的点。因为代表点和边界框的数量远小于轨迹中的点，所以我们可以快速过滤掉不同的轨迹。如图1(d) 所示，我们用四个点和三个边界框来表示一个 200 点的轨迹 T_4。p_{150} 是 T_4 的第三个代表点，它远离Q，所以我们可以快速消除T_4。最后，只有少数轨迹必须计算全局修剪和局部过滤后不可避免且耗时的相似度。</p>

<p><strong>2 索引和存储</strong></p>

<p>本节详细探讨如何在key-value数据库中利用XZ*索引来表示轨迹。索引包括两个主要操作，即索引结构和编码设计。然后，我们提取代表性特征以近似表示轨迹。最后介绍了如何存储轨迹。</p>

<p><strong>2.1 索引结构</strong></p>

<p>我们提出了一个细粒度的静态索引，即 XZ*，它可以近似地表示轨迹的形状。首先，我们使用四叉树的规则将整个空间分成许多不同分辨率的子空间，然后给每个子空间一个quadrant sequence。之后，受 XZ-ordering启发，我们将每个子空间的高度和宽度向右上角加倍，以覆盖不同大小的轨迹。最后，为了近似反映轨迹的形状，我们将放大后的元素平均分为四个子区域。我们使用子区域的组合作为索引空间来表示轨迹，并给每个组合一个 position code 来表示其在放大元素中的相关位置，如图5(e) 所示。这样，我们就可以用一个不规则的索引空间来细致地表示一条轨迹。</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/TraSS/640-16602942945085.jpeg" alt="img" /></p>

<p>图5 XZ*</p>

<p><strong>2.2 编码方案</strong></p>

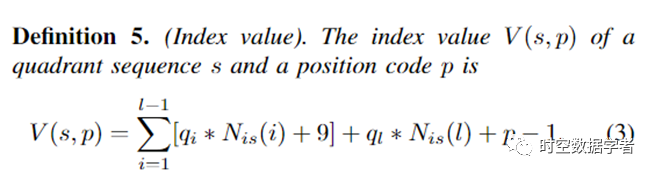
<p>Key-value数据库使用键值对的形式来存储数据。我们设计了一个双射函数来生成存储键以更好地支持轨迹数据存储和查询。我们双射函数编码的优点是：（1）轨迹的索引空间可以通过数学公式计算出来，而不需要维护内存中的索引结构。因此，我们可以减少轨迹管理系统的维护成本；(2)存储开销小于字符串编码。例如，对于 16 分辨率的索引空间，字符串编码需要 16 字节的象限序列和 1 字节的位置码，而我们的编码只需要 8 字节的整数，这样我们就可以减少键的存储开销 约 53%；(3) 使用简单的连接会使编码不连续，这样会增加查询时的key range搜索次数，降低性能。</p>

<p>我们的编码如下：</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/TraSS/640-16602942945086.png" alt="img" /></p>

<p>如图5(c) 和图5 (e) 所示，T_1 和 T_2 的索引值分别为 V(03, 2) = 40 和 V(03, 7) = 45。</p>

<p>V 是一个双射函数，因为每个索引空间只有一个索引值，而一个索引值只有一个索引空间。此外，象限序列和位置代码的字典顺序对应于索引值的不太等顺序，因此V保留了XZ*的空间特征。</p>

<p><strong>2.3 DP-Features</strong></p>

<p>现实世界中的轨迹可能包含很多点，因此相似度的计算成本很高。但是，许多连续点可能彼此非常接近。因此，我们使用 Douglas-Peucker (DP) 算法，在不影响精度的情况下减小轨迹的大小。DP是一种可以轻松实现的轨迹压缩算法，它可找到轨迹中具有代表性的点。此外，我们进一步提取可覆盖两个连续代表点之间所有点的边界框（缩写为bbox，它不一定平行于坐标轴），如图4（a）中所示的红色bbox（ 4）。</p>

<p><strong>2.4 存储方案</strong></p>

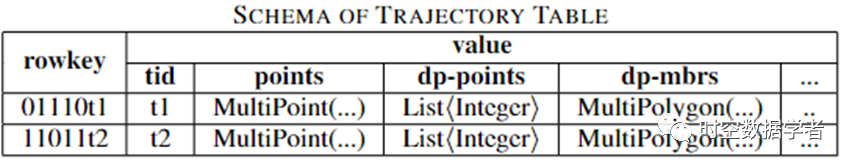
<p>我们使用一个不规则的索引空间来表示一个轨迹，并为索引空间分配一个索引值。因此，我们可以使用索引值作为存储和查询轨迹的空间键。键组合如下，</p>

<p>rowkey = shards + index~value + tid,</p>

<p>其中 `+’ 是连接操作；shards是一个散列值，用于分散轨迹，可以避免热点问题；index value表示轨迹的空间信息，由 公式3计算而来；tid 是轨迹的唯一标识符。</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/TraSS/640-16602942945087.png" alt="img" /></p>

<p>表中给出轨迹表的结构，其中 tid 是标识符，points列存储轨迹的原始时空点。值得注意的是，为了有效地执行轨迹相似性搜索，我们还需要列来存储一些有价值的特征，例如，dp-points 记录代表点在原始轨迹的位置，dp-mbrs 存储DP 特征的 MBR。注意，大部分key-value存储都有自动分区策略，所以本文不再进一步设计分区策略。</p>

<p><strong>3 查询处理</strong></p>

<p>在本节中，我们将描述如何处理轨迹相似性查询。我们首先给出我们的主要思想。基于主要思想，提出了两种剪枝策略，即全局剪枝和局部过滤。此外，我们将展示剪枝策略如何改进两个典型的轨迹相似性查询，即 Threshold Similarity Search 和 Top-k Similarity Search。</p>

<p><strong>3.1 主要思想：</strong></p>

<p>轨迹按照表1的结构进行存储，并且通过行键进行搜索。每个行键都配有一个表示轨迹形状的索引值。查询处理旨在消除与查询轨迹不相似的索引空间，进而避免计算与不必要的轨迹的复杂相似性。我们设计了全局剪枝策略以巧妙地过滤掉包含与查询轨迹不相似的索引空间。本文通过放大的元素和位置代码表示一个索引空间。全局剪枝首先引理修剪掉不必要的放大元素，再利用策略来过滤掉剩余放大元素中不需要访问的位置代码。执行全局剪枝后，我们需要提取剩余的索引空间中覆盖的轨迹。为了减轻复杂相似度的计算，我们提出了基于代表性特征的局部过滤轨迹，可有效地过滤掉不同的轨迹。基于全局剪枝和局部过滤，我们实现中两个常用的相似性搜索，即 Threshold Similarity Search 和 Top-k Similarity Search。</p>

<p><strong>3.2 全局剪枝:</strong></p>

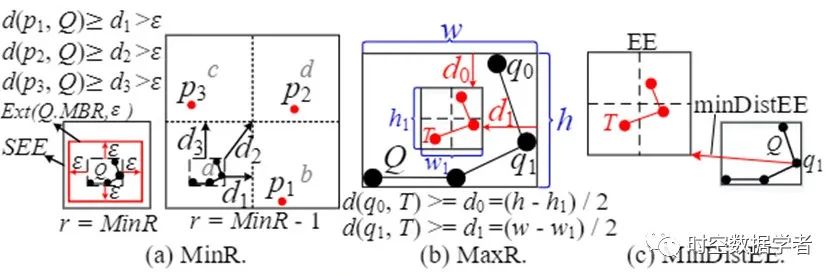
<p>轨迹具有空间形状。相似轨迹的形状通常与查询轨迹的形状相似。因此，不必要提取被太大或太小的索引空间索引的轨迹。因此， TraSS根据查询轨迹的空间形状，确定能包含相似轨迹的索引空间所处的最大和最小分辨率(maxR和minR)，如图6(a)(b)所示。进而，查询处理可根据minR和maxR过滤掉太大或太小的enlarged elements。此外，TraSS可根据轨迹与enlarged element的距离，即minDistEE，剪枝不相似的enlarged element。enlarged element仍然太大而无法精准表示轨迹。因此，我们提出了位置码的概念，它使用四个子区域的组合作为索引空间。TraSS可根据轨迹形状和索引空间的关系，剪枝不相似的索引空间，如图7所示。详细的剪枝流程，请参考原文给出的定义、引理和证明。</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/TraSS/640-16602942945088.jpeg" alt="img" /></p>

<p>图6 剪枝EE</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/TraSS/640-16602942945089.jpeg" alt="img" /></p>

<p>图7 剪枝索引空间</p>

<p><strong>3.3 局部过滤:</strong></p>

<p>过滤掉不必要的索引空间后，我们需要从key-value数据库中每个区域中提取候选索引空间索引的轨迹。TraSS设计的局部过滤将有助于以最小的计算成本剔除每个区域中的不相似轨迹。因为必须访问两条轨迹的所有点，所以计算两条轨迹的相似度非常耗时。因此，我们使用 DP 特征来精简地刻画表示轨迹，这可以有效地帮助查询处理过滤不同的轨迹，如图8(b)所示。详细的剪枝流程，请参考原文给出的定义、引理和证明。</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/TraSS/640-166029429450810.jpeg" alt="img" /></p>

<p>图8 DP-Feature过滤</p>

<p><strong>4 实现</strong></p>

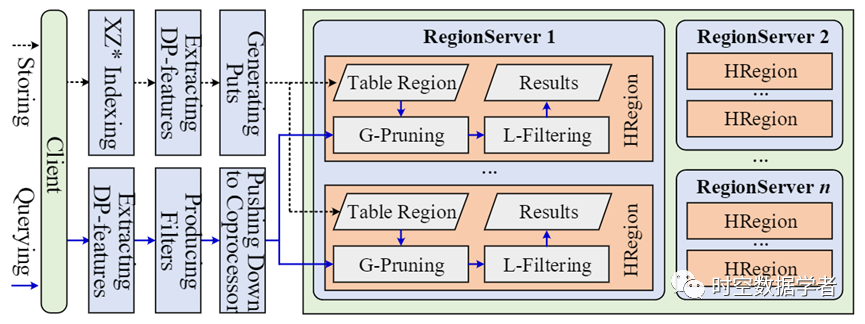
<p>如图9所示，我们基于 HBase（一种流行的key-value数据库）实现了 TraSS。首先，我们使用适当的索引空间对轨迹进行索引。然后，使用 Douglas-Peucker (DP) 算法来预先计算轨迹的 DP 特征。之后，我们将轨迹转换为 puts，并将所有 puts 插入 HBase 中。在执行相似度搜索时，我们首先计算查询轨迹的 DP 特征。然后，我们将全局修剪和局部过滤下推到 HBase 的协处理器中。最后，我们将查询结果返回给客户端。</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/TraSS/640-166029429450911.png" alt="img" /></p>

<p>图9 基于HBase的TraSS实现</p>

<p><strong>5 总结</strong></p>

<p>本文提出了TraSS，一种基于key-value数据库的轨迹相似性搜索框架。我们利用 XZ* 索引精准地表示key-value数据库中的轨迹，并为 XZ* 提供高效的编码来存储和查询key-value数据库中的轨迹。我们设计了高效的全局剪枝和局部过滤策略，有效地避免了访问不相似的轨迹。大量实验表明， TraSS 优于最先进的分布式解决方案。较XZ-Ordering索引， XZ* 索引可降低高达 66.4%的I/O 开销。TraSS 支持许多轨迹相似性度量，例如 Frechet、Hausdorff 和 DTW。此外，XZ* 索引支持空间范围查询。未来工作包括如何支持其他指标和其他空间查询。</p>

<p>有关 TraSS 的更多详细信息，请参阅：https://huajunge.github.io/academicpages/publication/2022-03-23-paper-title-number-1</p>

<p>报告视频：https://huajunge.github.io/academicpages/talks/2022-05-10-TraSSS</p>]]></content><author><name>Huajun He</name></author><category term="cool posts" /><category term="category1" /><category term="category2" /><summary type="html"><![CDATA[相似性搜索已成为许多轨迹数据分析任务的重要组成部分。随着物联网技术的快速发展，使得企业收集轨迹数据的途径变多、速度变快，导致许多轨迹分析任务必须从海量轨迹中寻找相似的轨迹。由于轨迹数据结构复杂，具有不规则的空间形状和连续的时间序列属性，存储和查询海量轨迹数据具有挑战性。西南交通大学博士生、京东实习生何华均为第一作者，郑宇教授和李天瑞教授为通讯作者，重庆大学李瑞远副教授、京东智能城市研究院-时空实验室鲍捷和何天赋，以及西安电子科技大学阮思捷博士共同完成的论文《TraSS: Efficient Trajectory Similarity Search Based on Key-Value Data Stores》提出了一种在key-value数据库中快速查询相似轨迹的高效方案。通常，海量轨迹数据可以通过key-value数据库进行管理。然而，现有的key-value数据库只能使用粗粒度的空间索引来存储轨迹数据，并且没有提供高效的查询处理算法来搜索相似的轨迹。TraSS提出了一种新颖的空间索引 XZ，它利用具有不同大小和不规则形状的索引空间来精细地表示轨迹的空间位置和形状。此外，TraSS设计了一个从 XZ 的多维索引空间到一维连续整数域的编码函数，可方便设计高效的轨迹存储策略和快速的轨迹查询处理算法。进一步地，为了提高相似性搜索的效率，TraSS采用两个步骤来修剪不相似的轨迹：（1）全局修剪。它利用 XZ* 索引来修剪没有相似于查询轨迹的索引空间。TraSS的全局剪枝只会挑选出与查询轨迹具有相似大小和形状的索引空间。与之前最先进的索引相比，TraSS的全局剪枝在查询处理过程中减少了高达 66.4% 的 I/O 开销；(2)局部过滤。它以降低相似度计算复杂度的方式来快速过滤不相似的轨迹。TraSS使用 Douglas-Peucker 算法从轨迹中提取代表性特征来加速局部过滤，极大地降低了查询处理过程中产生的计算量。大量实验和实际案例表明TraSS极大地提高了海量轨迹相似查询效率。]]></summary></entry><entry><title type="html">多维反向k近邻查询</title><link href="https://huajunge.github.io/academicpages/posts/2021/07/rknn/" rel="alternate" type="text/html" title="多维反向k近邻查询" /><published>2021-07-20T00:00:00+08:00</published><updated>2021-07-20T00:00:00+08:00</updated><id>https://huajunge.github.io/academicpages/posts/2021/07/rknn</id><content type="html" xml:base="https://huajunge.github.io/academicpages/posts/2021/07/rknn/"><![CDATA[<p>近十年来，空间点数据的反向<em>k</em>最近邻(R$k$NN)查询引起了研究者的广泛关注。给定一个数据点 <em>q，</em>反向<em>k</em>最近邻(R$k$NN)查询查找每一条将<em>q</em>当作它的<em>k</em>个近邻之一的数据点。由于<em>q</em>与这些数据点很接近，所以<em>q</em>对这些点的影响很大。例如，居民有极大的可能会去最近的<em>k</em>个商店购物。因此，在市场调研中，可以通过检索所有将这家商店当作<em>k</em> 个最近邻之一的居民点，来评估一家新开的便利店<em>q</em>潜在的客户。R$k$NN还可在更多的商业选址场景中使用，具有很重要的现实意义和实用价值。在本文中，提供一种设施或服务的对象(如购物市场、加油站)称为设施，使用该设施的对象(如居民、司机)称为用户。在这个上下文中，给定一个查询设施<em>q</em>, 其R$k$NN返回所有将<em>q</em>作为<em>k</em>个最接近的设施之一的用户。本文将基于这种上下文介绍四种R$k$NN算法, 即six regions 、TPL、FINCH、InfZone。</p>

<p><span id="wc" style="font-size: 1rem;text-align: center;">[本文总阅读量: <span id="busuanzi_value_page_pv"></span>次]</span></p>

<center>JUST技术：多维反向k近邻查询</center>

<center>JUST-团队 何华均</center>

<h2 id="简介">简介</h2>

<p>近十年来，空间点数据的反向<em>k</em>最近邻(R$k$NN)查询引起了研究者的广泛关注。给定一个数据点 <em>q，</em>反向<em>k</em>最近邻(R$k$NN)查询查找每一条将<em>q</em>当作它的<em>k</em>个近邻之一的数据点。由于<em>q</em>与这些数据点很接近，所以<em>q</em>对这些点的影响很大。例如，居民有极大的可能会去最近的<em>k</em>个商店购物。因此，在市场调研中，可以通过检索所有将这家商店当作<em>k</em> 个最近邻之一的居民点，来评估一家新开的便利店<em>q</em>潜在的客户。R$k$NN还可在更多的商业选址场景中使用，具有很重要的现实意义和实用价值。在本文中，提供一种设施或服务的对象(如购物市场、加油站)称为设施，使用该设施的对象(如居民、司机)称为用户。在这个上下文中，给定一个查询设施<em>q</em>, 其R$k$NN返回所有将<em>q</em>作为<em>k</em>个最接近的设施之一的用户。本文将基于这种上下文介绍四种R$k$NN算法, 即six regions 、TPL、FINCH、InfZone。</p>

<p>注：本文大多数算法描述参考于[7]，更多R$k$NN算法和细节请参考原文。</p>

<h2 id="基本定义和步骤">基本定义和步骤</h2>

<p>R$k$NN查询分为双色R$k$NN查询和单色R$k$NN查询。</p>

<p><strong>双色R$k$NN查询</strong>：存在一个设施集<em>F</em>、一个用户集<em>U</em>。给定一个查询设施<em>q</em>(不一定在<em>F</em>中)，一个双色R$k$NN查询返回每个用户$u\in U$，对于这些用户$u, q$是{$q\cup F$}中离它最近的<em>k</em>个设施之一。</p>

<p><strong>单色R$k$NN查询</strong>：给定一组设施<em>F</em>和一个查询设施<em>q</em>(不一定在F中)，一个单色R$k$NN查询返回每个设施$f\in F$，其中<em>q</em>是{$q\cup F−f$}中离它<em>k</em>个最近的设施之一。</p>

<p>在本文中，我们关注的是在欧氏空间中回答R$k$NN查询。由于R$k$NN查询的大部分应用是基于位置的服务，几乎所有现有的技术(如six regions [3]、TPL[4，5]、FINCH[6]、InfZone[1]等)都集中在二维位置数据上。因此，我们重点介绍在二维数据集上的算法。此外，双色R$k$NN查询在实际场景中有更多的应用程序。因此，本文主要焦点是双色查询。所有这些算法都假设数据集被R-tree或其变体(如R*-tree)进行索引。因此，接下来的介绍中，我们还假设设施和用户数据集都由两个R*树进行索引。</p>

<p>假设$dist(a, b)$表示两个对象的欧式距离。对于一个用户<em>p</em>, 如果存在至少<em>k</em>个设施<em>F’</em>, 对于任意<em>f</em> $\in $ <em>F</em>’,  <em>p</em>到<em>f</em>的距离比<em>q</em>小，即$dist(p, f) &lt; dist(p, q)$，则用户<em>p</em>不可能是<em>q</em>的R$k$NN之一，因为<em>q</em>不可能是<em>p</em>的<em>k</em>NN。</p>

<p>由于数据集的数量可能十分庞大，通过遍历所有用户并判断其是否满足条件，这是十分耗时且不合理的操作。前文提到，数据集会被R*-tree索引，每个R*-tree节点包含了大量的数据。因此，可通过先剪枝不合适的R*-tree实体（一个节点或一条数据），来减少查询开销。如果一个用户R*-tree实体$e$与至少<em>k</em>个设施（不包含<em>q</em>）的距离小于$q$，那么$e$可以被剪枝，因为<em>e</em>中包含的所有数据都具有至少<em>k</em>个比<em>q</em>近的设施。因此它们不可能是<em>q</em>的R<em>k</em>NN。</p>

<p>每个算法都可以分成两个步骤：</p>

<p><strong>Filtering:</strong> 过滤阶段，每个算法使用一组设施来过滤不包含R$k$NN的搜索空间。由于使用所有数据的可能非常昂贵，算法首先会挑选一些设施来过滤搜索空间。这些设施称为过滤设施，包含这些设施的集合称为过滤集(表示为$S_{fil}$)。</p>

<p>**Verification: **验证阶段，检索不能使用$S_{fil}$过滤的用户，它们是可能的R$k$NN，称为候选用户。然后通过确认它是否是R$k$NN来验证每个候选用户。</p>

<h2 id="算法">算法</h2>

<p><strong>(1) Six-regions</strong></p>

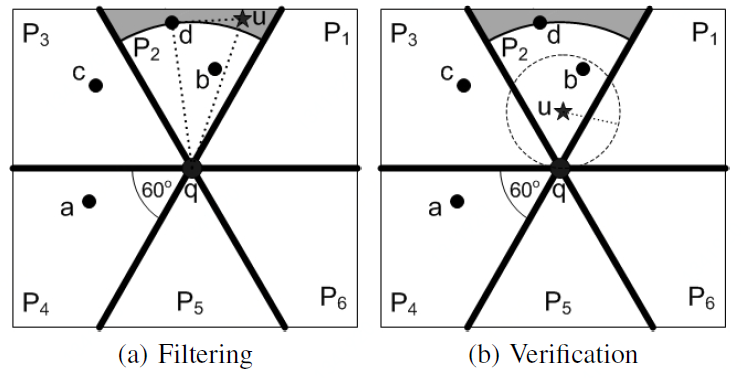
<p><strong>Filtering</strong>: Stanoi等人[3]提出了一种基于Six-regions(6个区域)的方法，将以查询<em>q</em>为中心的整个空间划分为6个相等的区域，每个区域60$^{\circ}$，(下图中的P1到P6)。每个区域中，<em>q</em>的第<em>k</em>个最接近的设施定义了可以过滤的区域。换句话说，假设$d_i^k$是区域$P_i$中<em>q</em>与其第<em>k</em>个最近的设施之间的距离。那么任何在$P_i$中并且距离<em>q</em>大于$d_i^k$的用户<em>u</em>都不能是<em>q</em>的R$k$NN。</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/rknn/image-20210719163928935-16497356755051.png" alt="image-20210719163928935" style="zoom: 50%;" /></p>

<p>上图中展示了一个R<em>k</em>NN (<em>k</em> = 2)查询，设施包含<em>q</em>和四个编号从<em>a</em>到<em>d</em>的设施。在区域$P_2$中，<em>d</em>是距离<em>q</em>第二近的设施，则阴影区域可以被过滤，即$P_2$区域中只有位于白色区域的用户可以是R$k$NN。处于阴影区域的用户<em>u</em>不能是R$k$NN，因为它肯定更接近<em>b</em>和<em>d</em>，则所有<em>u</em>的<em>k</em>NN(<em>k</em>=2)不可能包含$q$。可以用三角形证明处于阴影部分的用户必然远离$q$。例如，对于设施<em>d</em>和用户<em>u</em>，可形成△qdu（如图（a））。因为$\angle dqu \le 60^{\circ}$ ， 并且 $\angle qdu \ge 60^{\circ}$, 则 $dist(u,d) \le dist(u,q)$（大角对大边）。</p>

<p><strong>Verification</strong>: 如前所述，位于分区$P_i$中的用户<em>u</em>，如果$dist(u,q) &gt; d_i^k$，则$u$不能是$q$的R$k$NN 。在验证阶段，通过访问用户R*-tree来检索候选用户，并过滤mindist(<em>e</em>, <em>q</em>) &gt;$d_i^k$的节点, 并通过Filtering步骤过滤$dist(u,q) &gt; d_i^k$的用户，得到候选用户。然后每个候选用户通过一个布尔范围query来验证是否是<em>q</em>的R$k$NN。布尔查询以<em>u</em>为中心，半径为$dist(u, q)$作圆。当且仅当在以<em>u</em>为中心的圆中只有小于<em>k</em>个设施时，返回true，$u$是$q$的R$k$NN。如图(b)所示，以$u$为圆心，半径为$dist(u,q)$的圆，只包含两个设施。因此$u$为$q$的R$k$NN(<em>k</em>=2)。</p>

<p><strong>(2) TPL</strong></p>

<p><strong>Filtering</strong>: Tao等人[4，5]提出的TPL可以说是R$k$NN查询中最流行的算法。他们首次将半空间剪枝的概念用于R$k$NN查询，并激发了许多后续工作。给定一个设施<em>f</em>和一个查询<em>q</em>, <em>f</em>和<em>q</em>之间的一条垂直平分线$B_{f:q}$ 将空间分成两半。设$H_{f:q}$表示包含<em>f</em>的半空间，$H_{q:f}$表示包含<em>q</em>的半空间，位于$H_{f:q}$中的每个点<em>p</em>，都满足$dist(p, f) &lt; dist(p, q)$，也就是说，<em>f</em>可以裁剪位于$H_{f:q}$中的每个点<em>p</em>。</p>

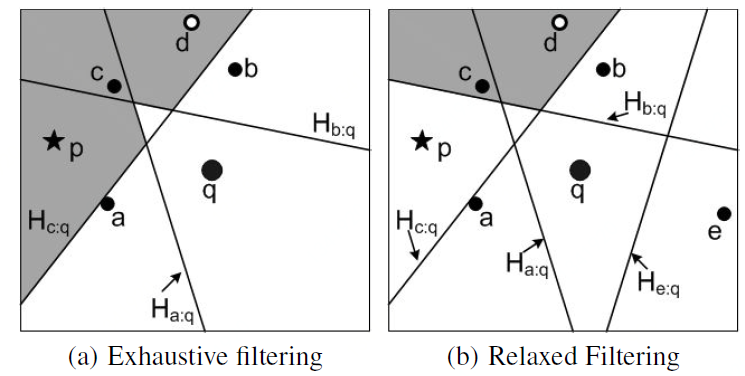
<p>考虑下图(a)的例子，其中包含了一个查询<em>q</em>和四个设施（a到d）。因为<em>p</em>位于$H_{a:q}$中，因此，$dist(p, a) &lt; dist(p, q)$，所以点<em>p</em>可以被设施<em>a</em>裁剪。请注意，被至少<em>k</em>个半空间裁剪的点<em>p</em>才不能是<em>q</em>的R$k$NN，才可以被过滤。如下图，假设<em>k</em> = 2，点<em>p</em>可以被过滤，因为它会被$H_{a:q}$和$H_{c:q}$裁剪。</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/rknn/image-20210719201424676-16497356755052.png" alt="image-20210719201424676" style="zoom:50%;" /></p>

<p>​</p>

<p>TPL的过滤算法从根节点开始访问设施R*-tree的节点，并将它们按与<em>q</em>的最小距离升序排列放入堆中。迭代地访问堆，如果一个被访问的实体<em>e</em>（可以是一个节点或者一个设施）可以被过滤(例如，<em>e</em>被至少<em>k</em>个设施裁剪)，它将被忽略。否则，如果<em>e</em>是中间节点或叶节点，则将其子节点插入堆中。另一方面，如果<em>e</em>是一个设施，且无法裁剪，则将其插入过滤集$S_{fil}$中，其半空间用于过滤搜索空间。当堆为空时，过滤算法终止。在图(a)中，假设过滤算法以$b、c、a、d$的顺序迭代访问设施，当访问设施$b、c、a$时(即$S_{fil}= {b, c, a}$)，过滤区域由半空间$H_{b:q}, H_{c:q}, H_{a:q}$的交集组成。如果<em>k</em> = 2，则阴影区域可以被过滤，因为其中的每个点都位于至少两个半空间中。如，当访问设施<em>d</em>时，可以使用筛选集对它进行剪枝。因此，在$S_{fil}$中不用插入<em>d</em>。</p>

<p>上面提到，TPL中的一个重要操作是确定设施实体是否可以使用一组过滤设施$S_{fil}$进行过滤。一种穷举的过滤策略如下：</p>

<p>设$S_{fil}$为包含<em>m</em>≥<em>k</em>个设施的过滤集，${f_1,…,f_k)}$为$S_{fil}$任意一个包含$k$个设施的子集。它们形成的过滤空间为 $\cap_{i=1}^{k} H_{f_i:q}$，每一个出现在这个空间中的点将被过滤。穷举过滤策略枚举每个这样的子集，并检查是否可以使用这些子集过滤R*-tree的节点。但是，这样的子集数量($C_m^{k}$)可能会很大。因此，TPL在过滤能力上做出了妥协，使用了以下成本较低的过滤策略(以下称为宽松过滤策略)。</p>

<p>首先，TPL根据希尔伯特值(Hilbert)对$S_{fil}$中设施按其空间位置进行排序。设排序后的顺序为$S_{fil} ={f_1,…,f_m)}$。然后，宽松过滤策略将其分成$m$个子集，分别为：${f_1,…,f_k)}$,${f_2,…,f{k+1})}$,…,${f_m,…,f{k-1})}$。总过滤成本为$O(km)$，因为要考虑m个子集，每个子集包含k个设施。如图(a), 假设$S_{fil} ={a,b,c}$。宽松过滤策略生成三个子集 ${a,b}$ 、${b,c}$和${c,a}$，并可过滤与穷举滤波相同的区域(即阴影区域)。这是因为在这种情况下，最大可能子集的个数等于<em>m</em>，即$C_{3}^{2} =3=m$。但是，在$S_{fil}$中添加一个新设施可能会减少过滤的面积，并且在添加该设施之前可以过滤的点可能不会再被过滤。假设设施<em>e</em>被插入，排序后的$S_{fil}$为${a, b, c, e}$。宽松过滤算法使用${a, b}， {b, c}， {c, e}和{e, a}$对搜索空间进行过滤。上图(b)展示了可以使用这些子集过滤的阴影区域。注意，经过过滤的区域已经变小，导致点<em>p</em>不能再被过滤。</p>

<p>为了更好地过滤节点<em>e</em>(节点或数据点)，TPL使用一种名为kTrim的算法。对于包含<em>k</em>个连续设施的$S_{fil}$的子集，该算法裁剪掉节点中可以被这个子集过滤的部分。kTrim使用每个子集（共<em>m</em>个）迭代地修剪节点。在任何阶段，如果整个节点被裁剪，节点或数据点就可以被过滤，算法就会停止。</p>

<p><strong>Verification</strong>： TPL迭代地访问用户R*-tree的节点，并使用$S_{fil}$对它们进行过滤。无法筛选的用户被插入到候选集中。与六个区域不同，TPL不会使用布尔范围查询来验证候选区域。取而代之地，TPL使用了一种更聪明的策略，它要求R*-tree的每个节点最多访问一次。具体地说，在过滤阶段遇到的设施R*-tree的节点和数据点保持在集合<em>P</em>中，验证算法轮询运行。在每一轮中，P中的一个节点被取出，并将其子节点被插入到P中。选择被取出的节点是基于它可以验证多少个候选节点。在每一轮中，利用P中的节点和数据点来识别可以用P验证的候选项，即可以确认为R$k$NN或保证不为R$k$NN。这样的候选项将被验证并从候选者集中删除。当候选集为空时，算法停止。</p>

<p><strong>(3) FINCH</strong></p>

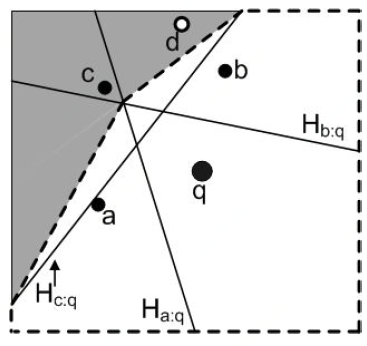
<p><strong>Filtering</strong>: Wu等人提出了一种名为FINCH的算法[6]，旨在通过使用一种更方便的过滤策略来改进TPL。具体来说，它不使用子集来过滤节点，而是使用一个包围不能被过滤区域的凸多边形。多边形之外的任何条目都可以被过滤。考虑图(a)的例子，其中白色区域是非过滤的区域。FINCH用一个凸多边形来近似这个区域(参见下图中的白色区域，边界用虚线表示)。任何在这个多边形之外的节点都可以被过滤，也就是阴影部分。</p>

<p>凸多边形的计算成本较高，并且，每当一个新的设施添加到$S_{fil}$，它需要$O(m^2)$的时间开销来计算凸多边形，其中$m$是过滤集$S_{fil}$中设施的数量。然而，FINCH的过滤比TPL更有效，因为判断一个点是否包含在凸多边形里，可以在对数$O(log ~m)$时间内完成。因此，可以在$O(log ~m)$内过滤一个点。过滤一个节点需要$O(m)$，因为它可能需要计算矩形与凸多边形的交点。</p>

<p><strong>Verification</strong>: 识别凸多边形内的用户并将其插入到候选集中。与6区域方法类似，每个候选用户都需要使用布尔范围查询进行验证。</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/rknn/image-20210719220604141-16497356755054.png" alt="image-20210719220604141" style="zoom:50%;" /></p>

<p><strong>(4) InfZone</strong></p>

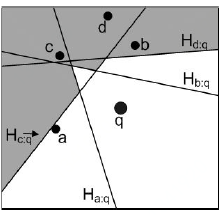
<p><strong>Filtering</strong>: Cheema等人[1，2]提出InfZone算法，利用影响区域的概念来改善验证阶段。影响区域是指当且仅当<em>p</em>位于该区域内时，点<em>p</em>为<em>q</em>的R$k$NN的区域。一旦计算了影响区域，就可以通过定位位于影响区域内的用户来回答R$k$NN查询。一种方法建立影响区的方法是绘制所有设施的半空间，被小于<em>k</em>个设施过滤的区域对应于影响区。例如，在下图中，<em>q</em>和所有设施之间的半空间被绘制为$Ha:q, Hb:q, Hc:q，和Hd:q$, 则阴影区域是过滤区域，白色区域是影响区域。回想一下，FINCH和TPL没有考虑$Hd:q$，因为当访问<em>d</em>时，会发现它位于过滤区域，因此会被忽略。作者提出了几个性质，以减少必须考虑的设施的数量，以正确计算合适的影响区域。该算法首先初始化影响区域为整个数据空间(矩形)。每当访问设施<em>f</em>时，其半空间$Hf:q$用于更新影响区，例如，通过删除至少<em>k</em>个设施修剪的部分。对于当前影响区域的每个顶点<em>v</em>，如果$minDist(e,v) &gt; dist(v,q)$, 则不需要这个实体<em>e</em>(一个节点或一个设施)计算影响区域。因此，该算法只考虑不满足该条件的实体。请注意，检查是否需要设施实体需要$O(m)$，因为遍历影响区域的顶点数为$O(m)$。当在$S_{fil}$中插入新设施时，更新影响区域需要$O(m^2)$，其中<em>m</em>是$S_{fil}$中的设施总数。在它的扩展版[2]中，该成本优化到了$O(km)$。</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/rknn/image-20210720095635450-16497356755053.png" alt="image-20210720095635450" style="zoom:50%;" /></p>

<p><strong>Verification</strong>: 根据影响区域的定义，当且仅当<em>p</em>在影响区域内时，点<em>p</em>为R$k$NN。因此，算法将迭代访问用户R*-tree的实体，并忽略不与影响区域重叠的实体。位于影响区域内的用户则为R$k$NN。结果表明，影响区域为星形多边形，点包含在星形多边形边数可以在对数时间内完成，即验证用户的成本为$O(log~ m)$。为了过滤一个用户节点(即一个矩形)，需要判断矩形是否与影响区相交，它花费$O(m)$。为了加快检查某个实体(节点或点)是否与影响区域重叠，InfZone被近似为两个圆:一个完全包含影响区域，另一个完全包含它（所有影响区域）。首先对照这些圆检查每个实体的重叠部分，以确定是否与影响区重叠。</p>

<p><strong>复杂度分析：</strong></p>

<table>
  <thead>
    <tr>
      <th>过滤方法</th>
      <th>six-regions</th>
      <th>TPL</th>
      <th>FINCH</th>
      <th>InfZone</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>筛选设施节点</td>
      <td>O(1)</td>
      <td>O(km)</td>
      <td>O(m)</td>
      <td>O(m)</td>
    </tr>
    <tr>
      <td>筛选设施数据点</td>
      <td>O(1)</td>
      <td>O(km)</td>
      <td>O(log m)</td>
      <td>O(m)</td>
    </tr>
    <tr>
      <td>在$S_{fil}$中增加一个新设施</td>
      <td>O(log k)</td>
      <td>O(log m)</td>
      <td>O($m^2$)</td>
      <td>O($m^2$)</td>
    </tr>
  </tbody>
</table>

<table>
  <thead>
    <tr>
      <th>验证方法</th>
      <th>six-regions</th>
      <th>TPL</th>
      <th>FINCH</th>
      <th>InfZone</th>
      <th> </th>
      <th> </th>
      <th> </th>
      <th> </th>
      <th> </th>
      <th> </th>
      <th> </th>
      <th> </th>
      <th> </th>
      <th> </th>
      <th> </th>
      <th> </th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>过滤用户节点</td>
      <td>O(1)</td>
      <td>O(km)</td>
      <td>O(m)</td>
      <td>O(m)</td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
    </tr>
    <tr>
      <td>过滤用户点</td>
      <td>O(1)</td>
      <td>O(km)</td>
      <td>O(log m)</td>
      <td>O(log m)</td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
    </tr>
    <tr>
      <td>验证一个候选用户</td>
      <td>布尔范围查询</td>
      <td>范围查询</td>
      <td>布尔范围查询</td>
      <td>O(log m)</td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
      <td> </td>
    </tr>
    <tr>
      <td>预期候选人人数</td>
      <td>$\frac{6k</td>
      <td>U</td>
      <td>}{F}$</td>
      <td>$\frac{k</td>
      <td>U</td>
      <td>}{F}$ 至 $\frac{6k</td>
      <td>U</td>
      <td>}{F}$</td>
      <td>$\frac{k</td>
      <td>U</td>
      <td>}{F}$ 至 $\frac{6k</td>
      <td>U</td>
      <td>}{F}$</td>
      <td>$\frac{k</td>
      <td>U</td>
      <td>}{F}$</td>
    </tr>
  </tbody>
</table>

<h2 id="参考文献">参考文献：</h2>

<p>[1] M. A. Cheema, X. Lin, W. Zhang, and Y. Zhang. Influence zone: Efficiently processing reverse k nearest neighbors queries. In ICDE, pages 577–588, 2011.</p>

<p>[2] M. A. Cheema, W. Zhang, X. Lin, and Y. Zhang. Efficiently processing snapshot and continuous reverse k nearest neighbors queries. VLDB J., 21(5):703–728, 2012.</p>

<p>[3] I. Stanoi, D. Agrawal, and A. E. Abbadi. Reverse nearest neighbor queries for dynamic databases. In ACM SIGMOD Workshop, pages 44–53, 2000.</p>

<p>[4] Y. Tao, D. Papadias, and X. Lian. Reverse knn search in arbitrary dimensionality. PVLDB, pages 744–755, 2004.</p>

<p>[5] Y. Tao, D. Papadias, X. Lian, and X. Xiao. Multidimensional reverse k nn search. VLDB J., 16(3):293–316, 2007.</p>

<p>[6] W. Wu, F. Yang, C. Y. Chan, and K.-L. Tan. Finch: Evaluating reverse k-nearest-neighbor queries on location data. PVLDB, 1(1):1056–1067, 2008.</p>

<p>[7] Yang, S., Cheema, M. A., Lin, X., &amp; Wang, W. (2015). Reverse k nearest neighbors query processing: experiments and analysis. PVLDB, <em>8</em>(5), 605-616.</p>]]></content><author><name>Huajun He</name></author><category term="cool posts" /><category term="category1" /><category term="category2" /><summary type="html"><![CDATA[近十年来，空间点数据的反向k最近邻(R$k$NN)查询引起了研究者的广泛关注。给定一个数据点 q，反向k最近邻(R$k$NN)查询查找每一条将q当作它的k个近邻之一的数据点。由于q与这些数据点很接近，所以q对这些点的影响很大。例如，居民有极大的可能会去最近的k个商店购物。因此，在市场调研中，可以通过检索所有将这家商店当作k 个最近邻之一的居民点，来评估一家新开的便利店q潜在的客户。R$k$NN还可在更多的商业选址场景中使用，具有很重要的现实意义和实用价值。在本文中，提供一种设施或服务的对象(如购物市场、加油站)称为设施，使用该设施的对象(如居民、司机)称为用户。在这个上下文中，给定一个查询设施q, 其R$k$NN返回所有将q作为k个最接近的设施之一的用户。本文将基于这种上下文介绍四种R$k$NN算法, 即six regions 、TPL、FINCH、InfZone。]]></summary></entry><entry><title type="html">管理海量空间数据的利器-空间填充曲线</title><link href="https://huajunge.github.io/academicpages/posts/2021/02/%E7%B4%A2%E5%BC%95/" rel="alternate" type="text/html" title="管理海量空间数据的利器-空间填充曲线" /><published>2021-01-22T00:00:00+08:00</published><updated>2021-01-22T00:00:00+08:00</updated><id>https://huajunge.github.io/academicpages/posts/2021/02/%E7%B4%A2%E5%BC%95</id><content type="html" xml:base="https://huajunge.github.io/academicpages/posts/2021/02/%E7%B4%A2%E5%BC%95/"><![CDATA[<p>现实世界中存在大量的多维空间数据，如加油站位置、河流走向等。为了高效存储和管理海量的空间数据，很多基于Key-Value存储的空间数据库，如GeoMesa[1]、JUST[2]，使用了空间填充曲线技术。它们将多维空间数据转换到一维空间上，并通过转换后的一维空间索引值存储和查询多维数据。本文详细介绍了几种常用的空间填充曲线(Z曲线、Hilbert曲线、XZ-Ordering)的映射算法。</p>

<p><span id="wc" style="font-size: 1rem;text-align: center;">[本文总阅读量: <span id="busuanzi_value_page_pv"></span>次]</span></p>

<p><strong>JUST技术：管理海量空间数据的利器-空间填充曲线</strong></p>

<p>JUST-团队 何华均</p>

<p>现实世界中存在大量的多维空间数据，如加油站位置、河流走向等。为了高效存储和管理海量的空间数据，很多基于Key-Value存储的空间数据库，如GeoMesa[1]、JUST[2]，使用了空间填充曲线技术。它们将多维空间数据转换到一维空间上，并通过转换后的一维空间索引值存储和查询多维数据。本文详细介绍了几种常用的空间填充曲线(Z曲线、Hilbert曲线、XZ-Ordering)的映射算法。</p>

<p>一、简介</p>

<p>随着基础设施和GPS终端的飞速发展，城市中出现了大量的空间对象。这些空间对象可以分为两种类型：点空间对象（例如，POI和GPS点）和空间扩展对象（例如道路、轨迹和行政区域）。许多城市应用通过空间范围查询来高度依赖于空间对象。例如，要预测空间区域的交通流量，我们应该首先需要检索位于该区域的轨迹以计算目前的流量。另一个例子是找到区域中POI、道路和其他空间对象以分析其功能。</p>

<p>但是，出于几个原因，管理空间对象是一项挑战。首先，空间物体通常固有地具有复杂的结构，因为它们通常包含至少纬度和经度的高维信息。对于空间扩展对象，则更加复杂，因为它们通常具有形状、大小、面积和其他属性。其次，空间数据通常具有巨大的规模。例如，每天有60,000多名快递员生成超过1TB的GPS日志，而NASA卫星数据档案库已经超过500TB [3]。具有空间插件的关系数据库，例如MySQL Spatial、Oracle Spatial或者PostGIS，通常会遇到可伸缩性问题，即当数据量到达一定程度时，系统往往不能工作。研究人员在诸如Spark和Hadoop的分布式平台中建立了R-tree，Quad-tree或KD-tree之类的空间索引，以管理大量的空间对象，但是它们可能会出现索引占用大量内存的问题。此外，空间物体是连续产生的。当出现新的空间数据时，这些基于Spark和基于Hadoop的空间数据管理系统通常需要从头开始重建索引以实现良好的查询效率，这非常耗时。为了克服所有上述问题，一些工作使用空间填充曲线（SFC）[4]，例如Z-Ordering[5]、Hilbert[6]、XZ-Ordering[7]，将高维的空间信息转化成了一维信息，在key-value数据库中管理空间对象。</p>

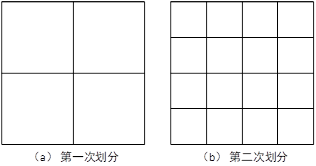
<p>空间填充曲线是一种降低空间维度的技术，是由意大利科学家皮亚诺于1890年首次构造出来的，并由希尔伯特于1891年正式提出的，之后空间填充曲线就得到了深入的研究和广泛的应用[5]。空间填充曲线将高维空间数据映射到一维空间，并利用转换后的索引值存储和查询数据。空间填充曲线通过有限次的递归操作将多维空间划分为众多的网格（如图1所示），再通过一条连续的曲线经过所有的网格。</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/索引/clip_image002.png" alt="img" /></p>

<p>图1、空间网格</p>

<p>从数学的角度上看，可以将空间填充曲线看成是一种把d 维空间数据转换到1维连续空间上的映射函数。实际上，存储磁盘是一维的存储设备，而空间数据是多维数据，不存在天然的一维顺序。因此，为了使空间上邻近的元素映射也尽可能是一维直线上接近的点，提出了许多的映射方法。最常用的方法包括Z-Ordering[5]、Hilbert[6]曲线和XZ-Ordering，其中Z-Ordering和Hilbert曲线主要用于管理点对象，XZ-Ordering用于管理空间扩展对象，如线和多边形对象。</p>

<p>二、点空间填充曲线</p>

<p>点对象是指只具有经度和纬度的二维空间数据。Z-Ordering和Hilbert曲线常用于管理点对象的空间填充曲线。</p>

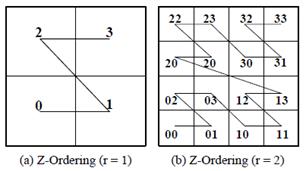
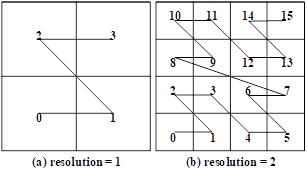
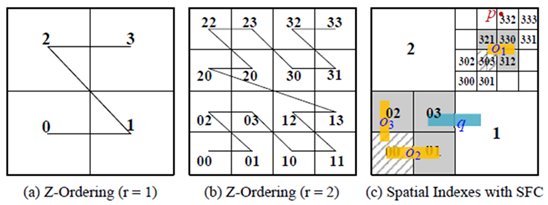
<p><strong>Z-Ordering:</strong> Z曲线是较简单的空间填充曲线。如图2所示，Z曲线递归地将空间分成四个子空间，直到达到最大递归次数r，最大分辨率控制着最小网格的大小。每一个空间分裂出的四个子空间分别按照图2（a）所示的方式从0到3编号。如果没有达到最大分辨率，则继续划分每一个子空间，并依次递归编码，如图2（b）所示。最终，每个最小网格都会有唯一的编码序列。我们通过一条曲线按照编码的字典序将最大分辨率下的所有网格连起来，可以看到每一层的编码形成的形状类似字母Z。通常，字符串的大小比较没有整数比较效率高，进而影响查询效率。因此，在实际使用中，会将Z曲线的编码序列转化为整数。如图3所示，Z曲线从整数0开始按照曲线的连接顺序对网格依次递增编码。</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/索引/clip_image004.jpg" alt="img" /></p>

<p>图2、Z曲线示意图</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/索引/clip_image006.png" alt="img" /></p>

<p>图3、数值化</p>

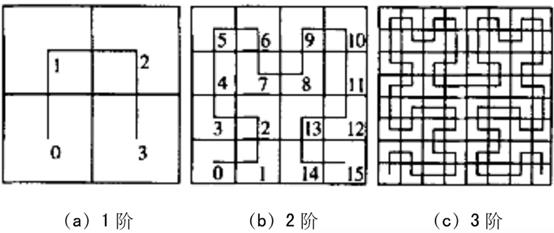
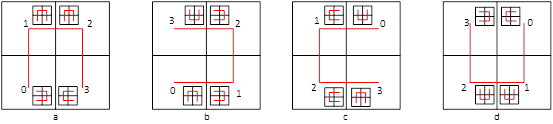
<p><strong>Hilbert</strong><strong>曲线</strong><strong>:</strong> Hilbert曲线是一种能填充满一个平面正方形的分形曲线（空间填充曲线），由大卫·希尔伯特在1891年提出，如图4所示。Hilbert曲线通过把一个正方形空间不断的分成4个子空间，再把小正方形的中心点连接起来得到的曲线，即希尔伯特曲线。在希尔伯特曲线的编码映射中，使用U字型来访问每个空间，对分成的4个子空间也同样使用U字形访问，但要调整U字形的朝向使得相邻的空间能够衔接起来。如图4（a），在第一层时，选择一个起始点和方向，然后用0到3依次给四个子空间编号。然而，当层数大于1时，维护总体的邻接特性，是一件较为复杂的过程。通过不断的观察，我们发现，子空间的曲线是由原空间的简单变换得来，而且只存在四种变换方式，并且相同的变换也适用于子空间的子空间等等。给定一个空间，我们根据它的U字形曲线朝向来确定其四个子空间的U字形曲线朝向和编号。如图5(a)所示，当U字形朝向为下时，Hibert曲线从左下角开始按照顺时针方向分别对其四个子空间编号为0到3，并且进一步划分四个子空间时，它们的U字型朝向分别为左、下、下、右。其它朝向的U字形变换和编号方式，如图5(b)(c)(d)所示。同样地，Hilbert曲线会按照曲线的前进顺序从整数0开始给所有最小的网格编码。</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/索引/clip_image008.jpg" alt="img" /></p>

<p>图4、Hilbert曲线示意图</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/索引/clip_image010.png" alt="img" /></p>

<p>图5、Hilbert曲线的四种变化</p>

<p>三、空间扩展填充曲线</p>

<p>空间数据除了点类型，还有大量的空间扩展对象，如线和多边形。它们通常具有长度、面积等属性。因此，不能被一个经纬度唯一表示。Z曲线和Hibert曲线最终得到的编码只能表示处于最大分辨率的网格。然而，一个空间扩展对象很可能会与多个最小网格相交，因此Z曲线和Hibert曲线都不能用唯一的编码值来表示它。为了利用空间填充曲线来表示空间扩展对象，最简单的方法是用所有与空间扩展对象相交的网格的对应编码表示它，然后将它拷贝多次并存储在每一个编码下。明显地，这种方法会带来额外的存储开销，并且在查询时需要时间执行去重操作。XZ-Ordering解决了上面提到的问题。它扩展Z曲线，提出了一个放大元素的概念。它固定住Z曲线每一个子空间的左下角，然后将其长和高都扩大一倍得到更大的索引空间，得到的索引空间称作扩大元素。如图6（c）中，子空间“00”被扩张到了“0”所覆盖的子空间，“303”扩张为由“303”、“312”、“321”、“330”这四个子空间组成的索引区域。最终，XZ-Ordering利用恰好能完全包含多边形的放大元素来表示多边形，如O1被“303”的扩大元素表示，O1和O3被“00”的扩大元素表示。</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/索引/clip_image012.png" alt="img" /></p>

<p>图6、XZ-Ordering示意图</p>

<p>由于XZ-Ordering使用到了不同分辨率的索引空间表示多边形对象，因此它的索引空间数量不只是最大分辨率的网格数量。因为，分辨率每增加一次，Z曲线的每个子空间都会分裂出四个新的子空间，而每个子空间也可以扩展为XZ-Ordering的扩大元素。因此，XZ-Ordering拥有个<img src="https://huajunge.github.io/academicpages/images/posts/索引/clip_image014.png" alt="img" />个处于分辨率<em>i</em>的索引空间。进而，它能表示的所有索引空间的数量为不同分辨率下的索引空间数量的累加值。XZ-Ordering实际能表示的索引空间数量为：</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/索引/clip_image016.png" alt="img" />+<img src="https://huajunge.github.io/academicpages/images/posts/索引/clip_image018.png" alt="img" />，</p>

<p>其中，<em>l</em>表示最大分辨率。</p>

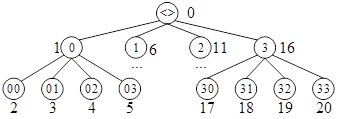
<p>XZ-Ordering同样会用一个整数来表示索引空间，并且尽量满足空间相近的索引空间具有相近的整数值。它的数值化思路可以理解为一种深度优先编码，如图7所示，为XZ-Ordering最大分辨率为2时的编码。先从第0层开始编码为0，然后再按照深度优先访问的顺序编码，如先编码第1层中子空间序号为“0”的空间为1，再编码“00”子空间为2。当编码完“0”开头的所有索引空间后，回退到上一层，再开始编码上一层为“1”的空间为6，再深度编码“1”下面所有的索引空间。</p>

<p><img src="https://huajunge.github.io/academicpages/images/posts/索引/clip_image020.png" alt="img" /></p>

<p>图7、XZ-Ordering最大分辨率为2时的编码</p>

<p>四、总结</p>

<p>空间填充曲线将多维数据转换到一维整数域上，并且尽可能保持了多维空间的特性，使得空间相近的空间在转换后的整数上也尽可能地相近。Z曲线和Hibert曲线是较为常用的空间填充曲线，其中Z曲线较容易实现。XZ-Ordering扩展了Z曲线，使得它能较好地表示非点空间对象，如线和多边形对象。</p>

<p>参考文献：</p>

<ol>
  <li>
    <p>https://www.geomesa.org/</p>
  </li>
  <li>
    <p>http://just.urban-computing.com/</p>
  </li>
  <li>
    <p>Ruiyuan Li, Huajun He, Rubin Wang, Yuchuan Huang, Junwen Liu, Sijie Ruan, Tianfu He, Jie Bao, and Yu Zheng. 2020. Just: Jd urban spatio-temporal data engine. In 2020 IEEE 36th International Conference on Data Engineering (ICDE). IEEE, 1558–1569.</p>
  </li>
  <li>
    <p>Tetsuo Asano, Desh Ranjan, Thomas Roos, Emo Welzl, and Peter Widmayer. 1997. Space-filling curves and their use in the design of geometric data structures. Theoretical Computer Science 181, 1 (1997), 3–15.</p>
  </li>
  <li>
    <p>https://en.wikipedia.org/wiki/Space-filling_curve</p>
  </li>
  <li>
    <p><a href="https://baike.baidu.com/item/希尔伯特曲线/938155?fr=aladdin">https://baike.baidu.com/item/%E5%B8%8C%E5%B0%94%E4%BC%AF%E7%89%B9%E6%9B%B2%E7%BA%BF/938155?fr=aladdin</a></p>
  </li>
  <li>
    <p>Christian Böhm, Gerald Klump, and Hans-Peter Kriegel. 1999. XZ-Ordering: A Space-Filling Curve for Objects with Spatial Extension. In Proceedings of the 6th International Symposium on Advances in Spatial Databases (SSD ‘99). Springer-Verlag, Berlin, Heidelberg, 75–90.</p>
  </li>
</ol>]]></content><author><name>Huajun He</name></author><category term="cool posts" /><category term="category1" /><category term="category2" /><summary type="html"><![CDATA[现实世界中存在大量的多维空间数据，如加油站位置、河流走向等。为了高效存储和管理海量的空间数据，很多基于Key-Value存储的空间数据库，如GeoMesa[1]、JUST[2]，使用了空间填充曲线技术。它们将多维空间数据转换到一维空间上，并通过转换后的一维空间索引值存储和查询多维数据。本文详细介绍了几种常用的空间填充曲线(Z曲线、Hilbert曲线、XZ-Ordering)的映射算法。]]></summary></entry></feed>